La plataforma
Cada gestión,
mejor que la anterior
Sniff! une la evaluación, la revisión, la disputa y el reporte para que puedas auditar todas las gestiones, encontrar qué falla y actuar antes de que se repita.
- 1GestiónLlamada o chat de WhatsApp, de una persona o de un bot
- 2ScorecardTus criterios, aplicados igual a todos
- 3EvaluaciónCumple / no cumple con justificación y cita
- 4Revisión o disputaEl evaluador corrige, el operador discute
- 5Reporte¿Mejoró de verdad la semana siguiente?
Un solo sistema de calidad
De cada gestión a la próxima mejor acción
- 01
Definí
Armá los criterios y el scorecard con tu pass rate.
Herramientas › Scorecards - 02
Evaluá
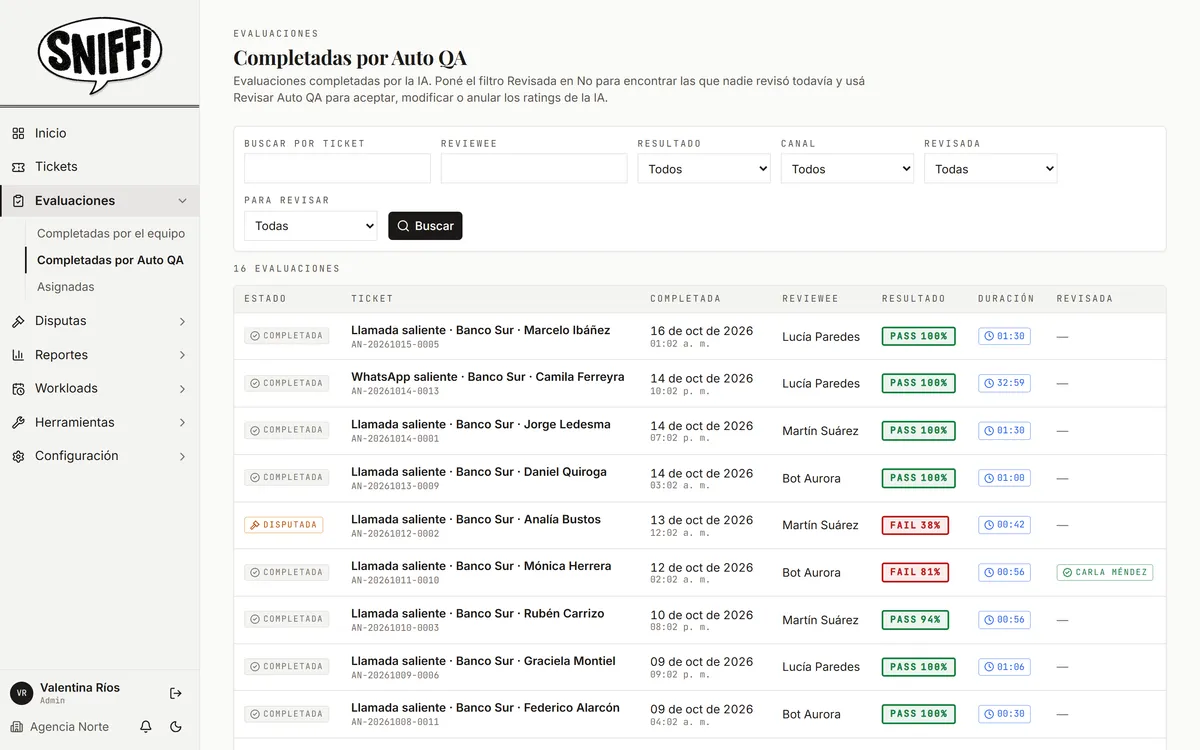
Un workload elige las gestiones y Auto QA las evalúa cada noche.
Workloads › Ciclos - 03
Revisá
Los evaluadores corrigen lo marcado y dejan feedback.
Evaluaciones › Completadas por Auto QA - 04
Disputá
Los operadores aceptan o disputan criterio por criterio.
Disputas - 05
Medí
Puntaje, tasa de disputa y precisión de la IA por período.
Reportes
Scorecards y criterios
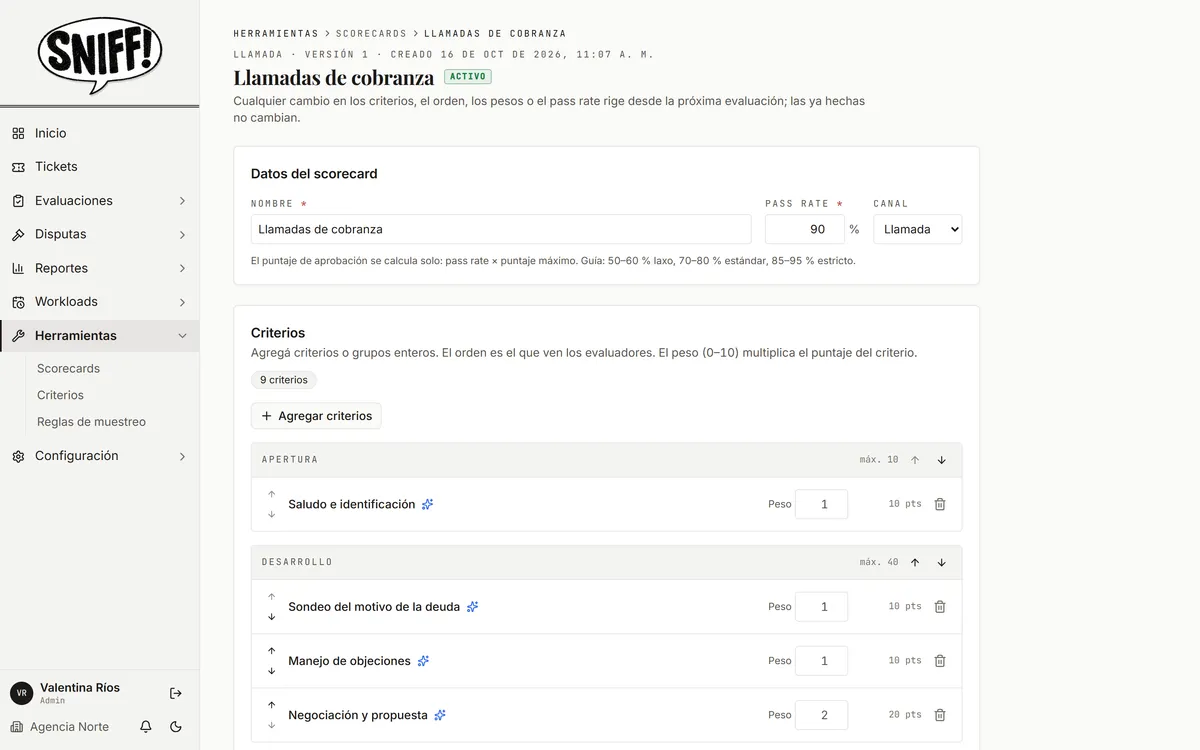
Tu estándar, escrito dos veces: para personas y para la IA
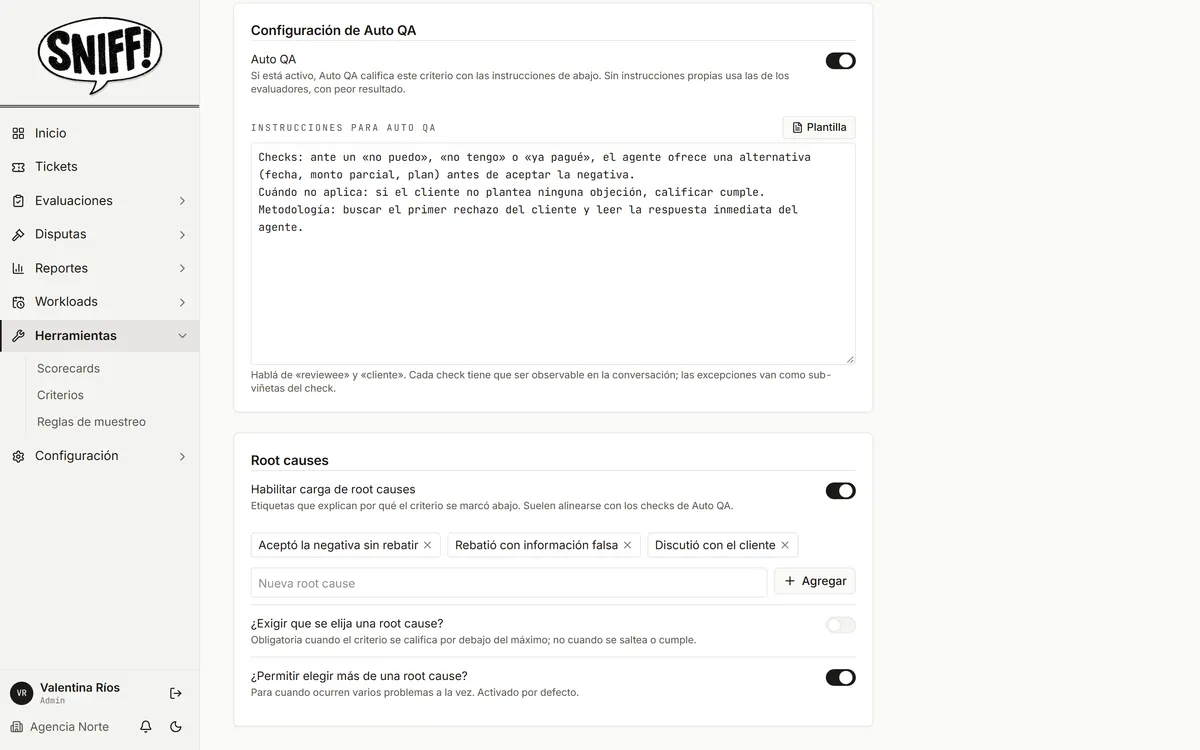
Cada criterio tiene instrucciones para los evaluadores y, aparte, instrucciones para Auto QA en un formato que la IA puede aplicar: qué chequear, cuándo no aplica y cómo decidir.
- Modos Estándar, Crítico y Soft. Un crítico reprobado deja la evaluación en 0 %.
- Pesos de 0 a 10 por criterio y pass rate por scorecard.
- No aplica sólo si el criterio lo permite; si no, cumple y queda marcado para revisar.
- Root causes por criterio, obligatorios o no, una o varias.
- Versiones: cada evaluación congela el scorecard con el que se hizo.
- Plantillas de cobranza para llamadas, WhatsApp, bot de voz y bot de WhatsApp.
Auto QA
Audita el 100 %, para humanos y para bots
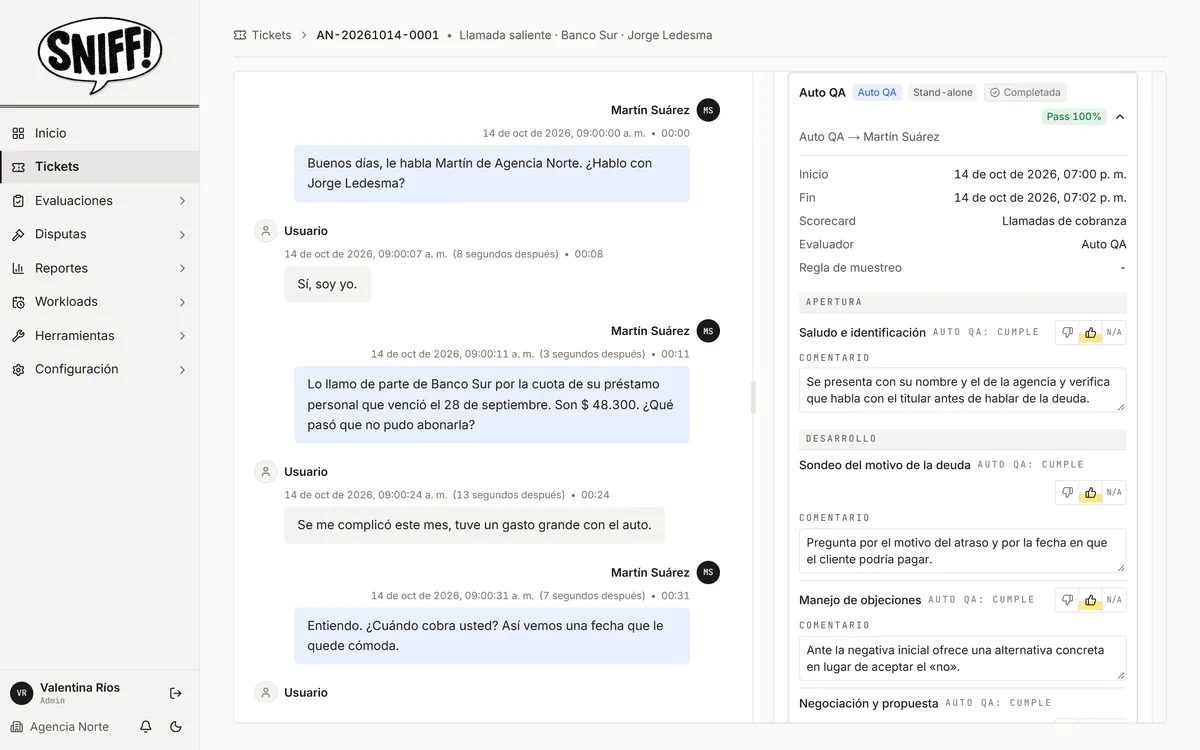
Auto QA escucha la llamada o lee el chat y evalúa cada criterio con tu scorecard. Da el rating, la justificación y la cita exacta de la conversación. Lo que no puede saber, como datos del sistema, lo deja marcado para revisar en lugar de inventarlo.
- Transcripción con separación de hablantes y detección de buzón de voz.
- Datos personales enmascarados antes de llegar a la IA.
- Críticos con confianza baja no anulan: quedan «Para revisar».
- Metadatos de la gestión (tipificación, campos del ticket) como contexto.
- «Volver a correr Auto QA» después de ajustar un criterio.
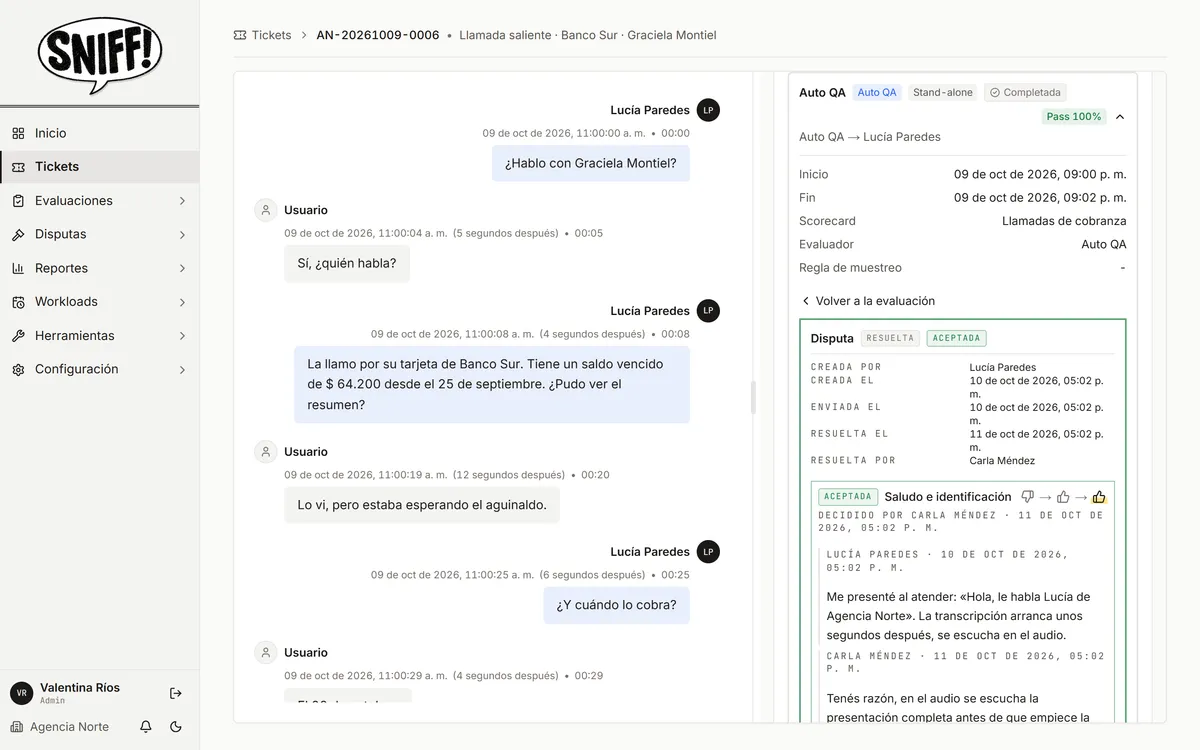
Revisión humana y disputas
La IA propone, las personas deciden
Los evaluadores revisan Auto QA criterio por criterio y cada cambio queda como corrección con feedback. Los operadores reciben la evaluación, la aceptan o la disputan, y el ciclo tiene reglas que configurás vos.
- Revisar Auto QA: rating, comentario y root cause por criterio; feedback obligatorio si cambia el rating.
- Co-pilot: la IA deja la evaluación lista y una persona la termina.
- Disputar sólo criterios en no cumple, con rating propuesto y comentario.
- Aprobación del líder de grupo, ventana de disputa, auto-aceptación al vencer.
- Resolver: aceptar, aceptar seleccionados o rechazar; el puntaje se recalcula en vivo.
Workloads y reglas de muestreo
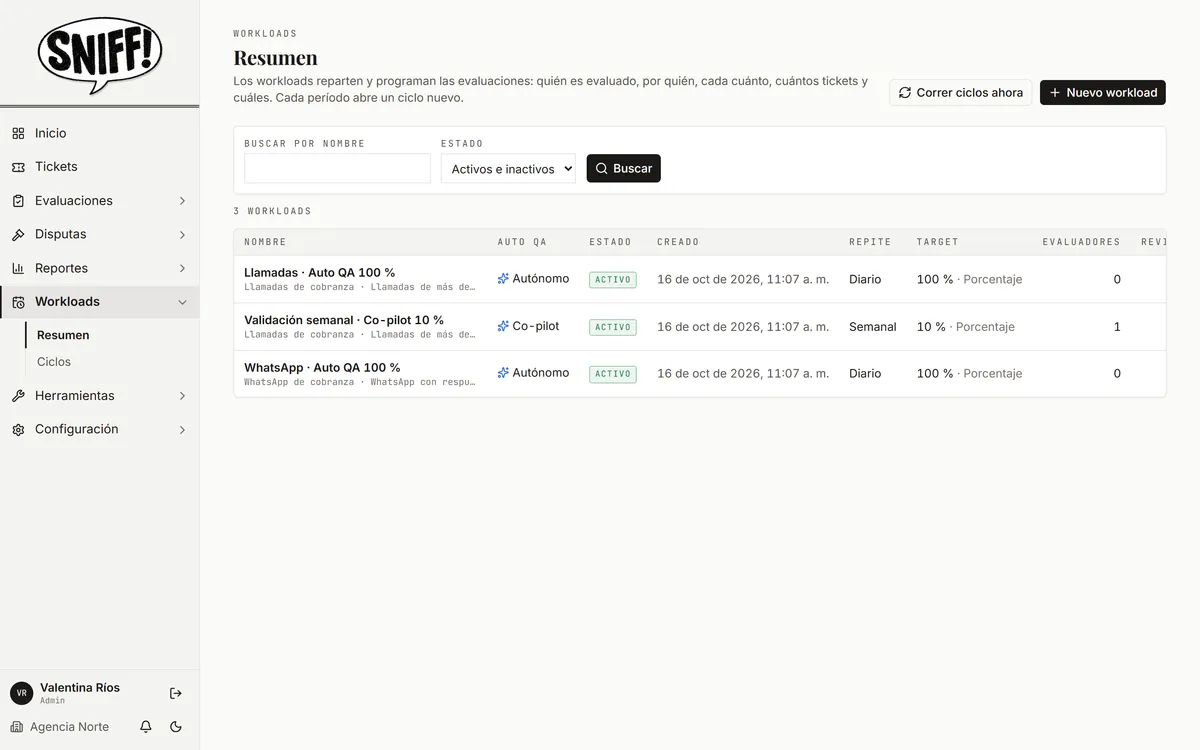
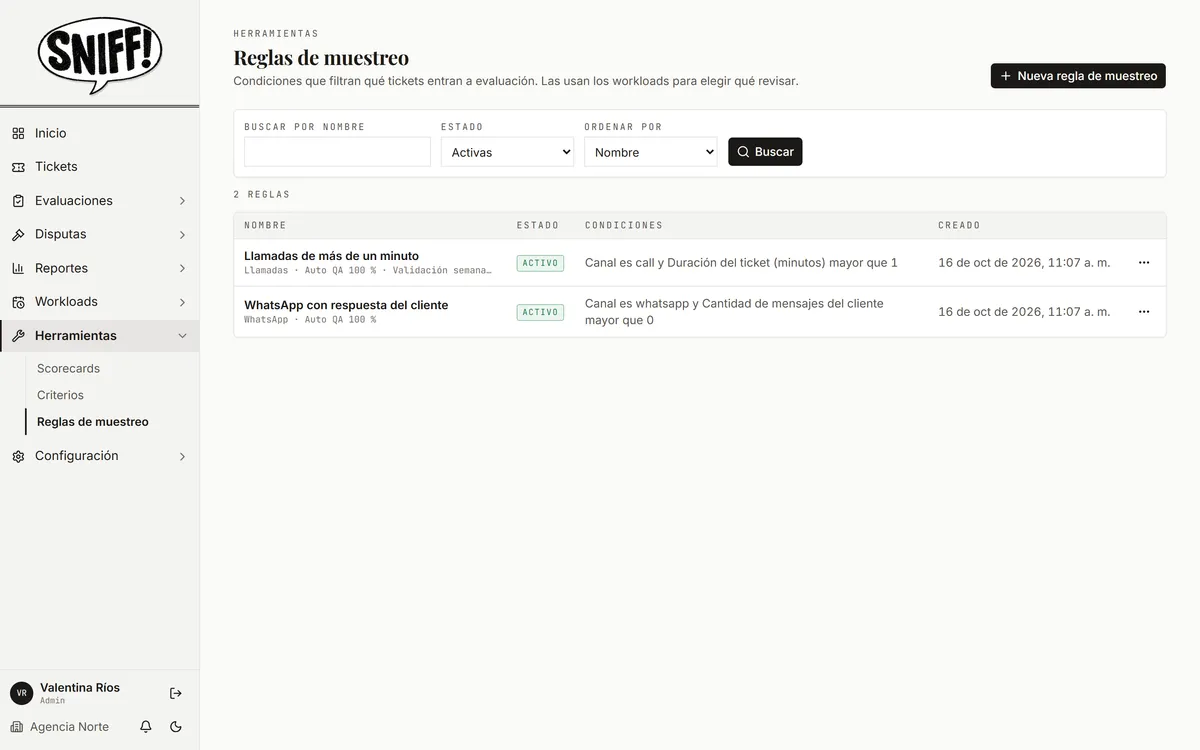
Vos decidís qué se evalúa, cuánto y cómo
Las reglas de muestreo filtran por canal, estado, duración, fechas, etiquetas y palabras clave, con vista previa. Un workload las combina con reviewees y un objetivo, y corre en ciclos diarios, semanales o mensuales.
- Objetivo Total, Por reviewee o Porcentaje.
- Reparto Autónomo (la IA sola) o Co-pilot (la IA prepara, una persona termina).
- Reevaluar o no lo que ya tiene evaluación.
- Ciclos Completado / Incompleto / Cancelado y «Correr ciclos ahora».
Reportes
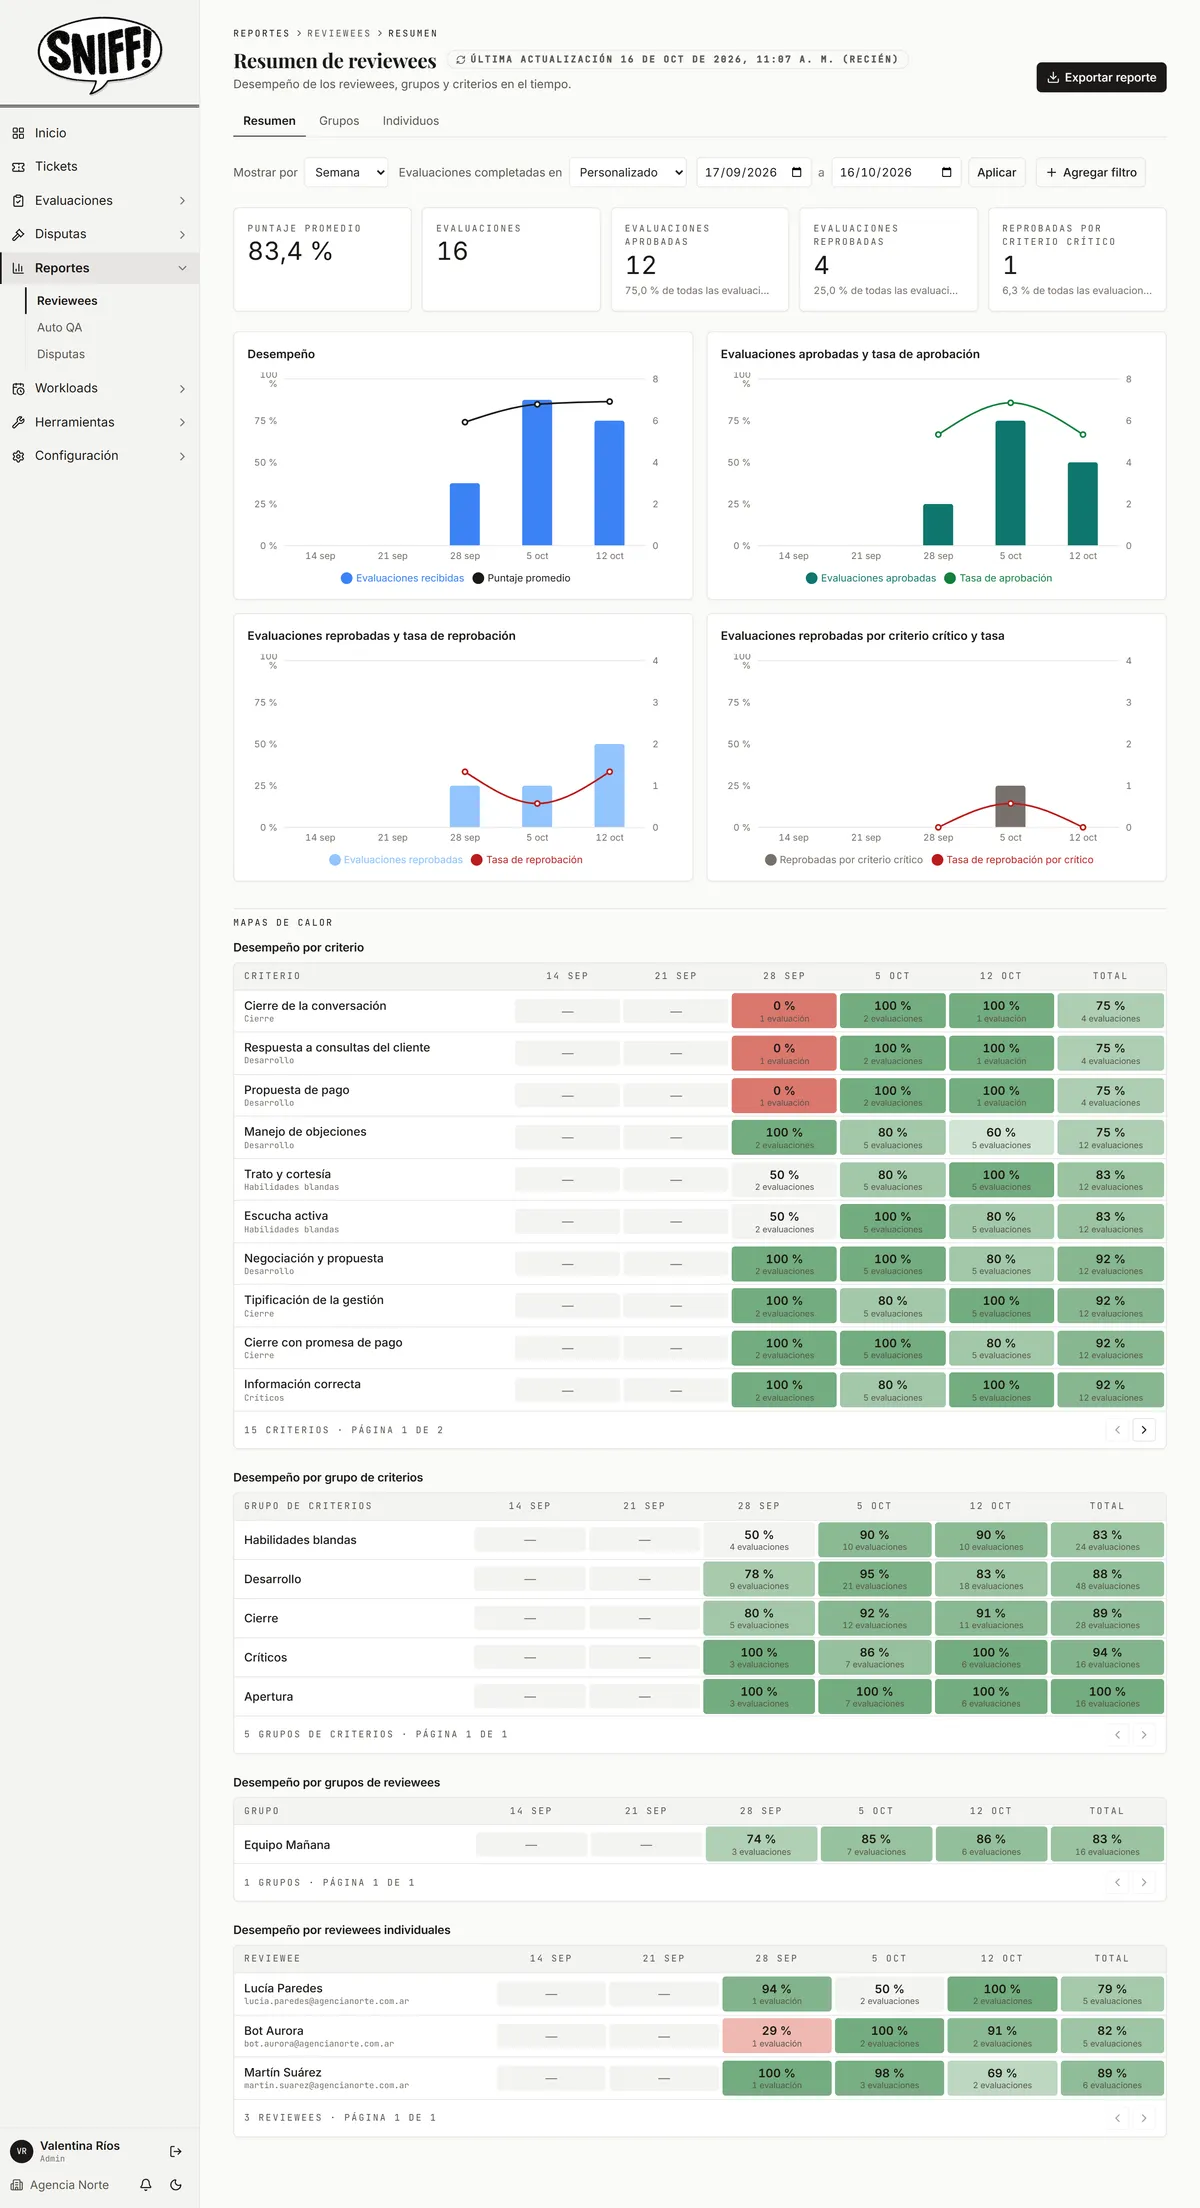
Mirá si la calidad mejora de verdad
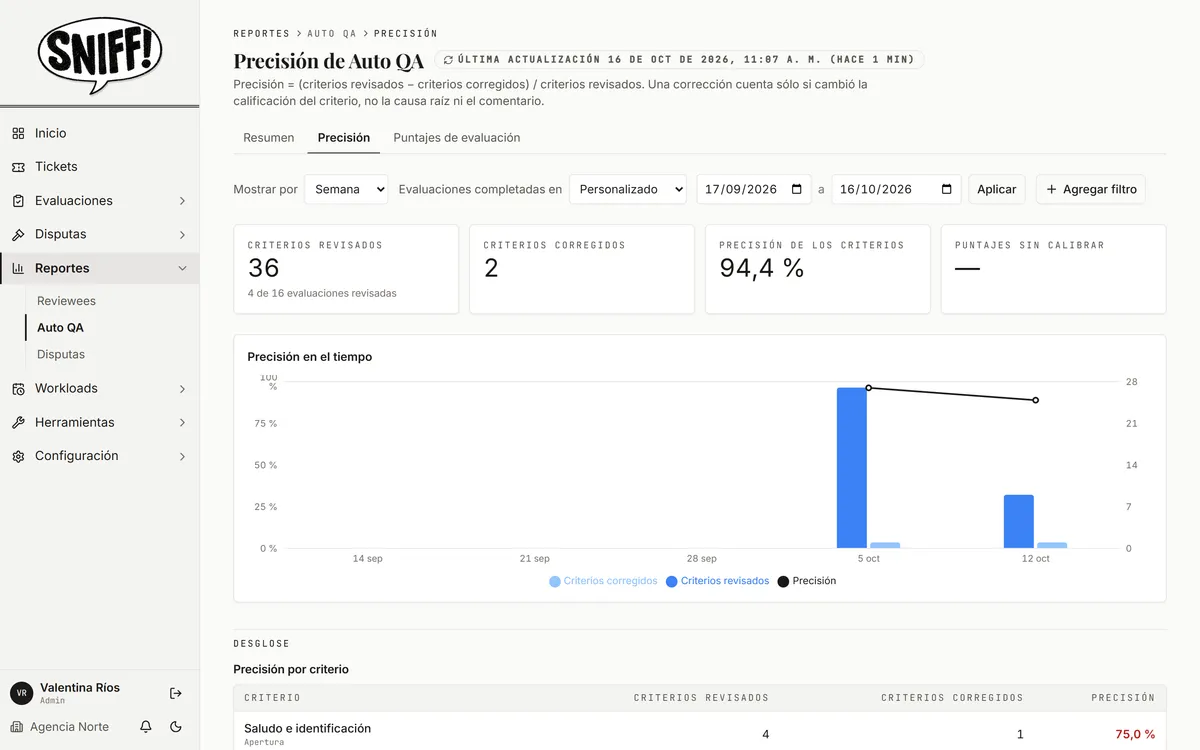
Puntaje y volumen por semana, mes o trimestre; mapa de calor por reviewee, grupo y criterio; disputas por evaluador y resultado; precisión de Auto QA a partir de las revisiones humanas. Cada rol ve lo que le corresponde.
- Reviewees: Resumen, Grupos e Individuos, con exportación a Excel.
- Auto QA: Resumen, Precisión (por período, criterio y revisor) y Puntajes.
- Disputas: Resumen, Evaluadores, Reviewees y Grupos.
- Filtros en la URL para compartir una vista exacta.
Conexiones
Cada gestión, con el contexto que la explica
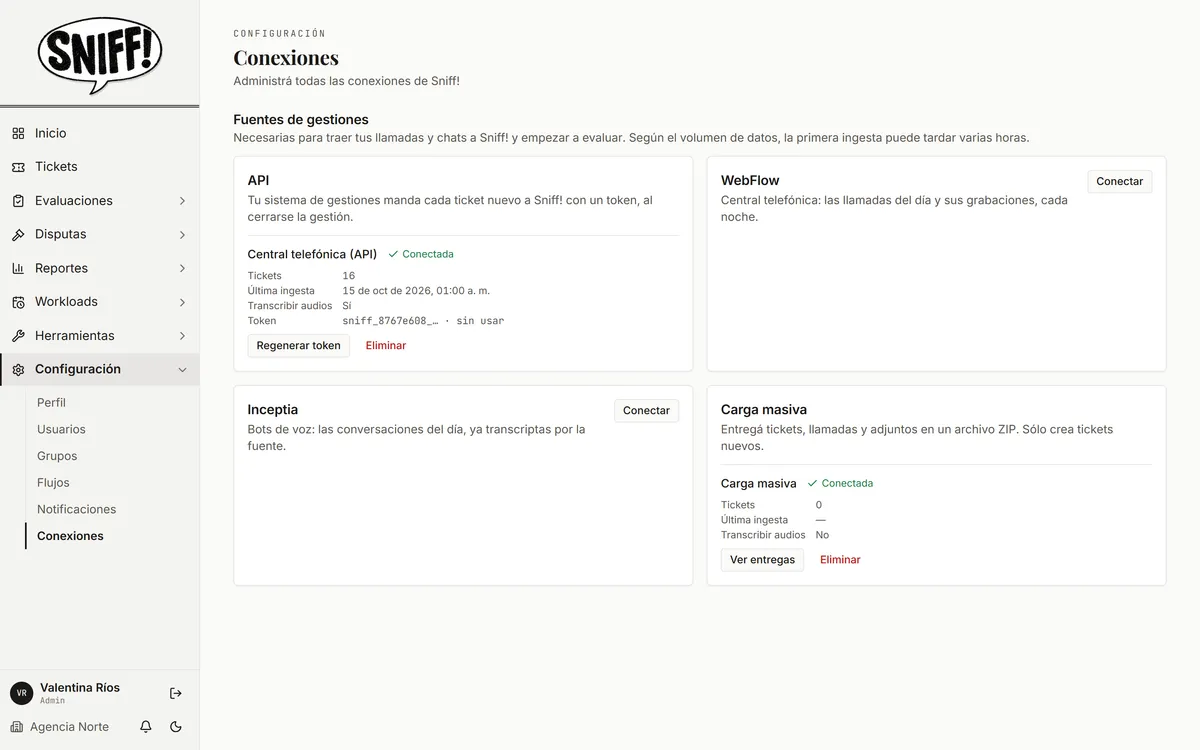
Todas las vías usan el mismo contrato de ticket: id, fecha, asignado, canal, grabación o mensajes y los campos propios que quieras mostrarle al evaluador y a la IA.
API
Un POST por gestión al cerrarse, con token por workspace.
Carga masiva
ZIP con manifiesto o CSV simple más audios, hasta 2 GB.
Central telefónica
Credenciales propias, «Probar conexión», llamadas del día.
Bot de voz
Turnos del bot y de la persona, audio y estado del caso.
Cómo funciona
Empezás con tu estándar. Escalás con confianza.
- 01
Conectá tus gestiones
API, carga masiva, central telefónica o proveedor de bots. Las llamadas se transcriben con separación de hablantes.
- 02
Armá tu marco de calidad
Criterios con instrucciones para personas y para la IA, pesos, críticos y pass rate. O empezá desde una plantilla de cobranza.
- 03
Calibrá
Comparás Auto QA con tus evaluadores sobre las mismas gestiones, leés los desacuerdos y ajustás las instrucciones.
- 04
Automatizá
Workloads que corren solos, revisión de lo dudoso, disputas con reglas claras y reportes que se actualizan cada media hora.
Que cada hallazgo sirva para algo
Mirá cómo Sniff! puede ayudar a tu equipo a evaluar más gestiones, dar mejor feedback y mejorar a personas y bots.