Auto QA
La IA que escucha
todas las llamadas
Auto QA aplica tu scorecard a cada gestión como lo haría un evaluador prolijo: criterio por criterio, con justificación y cita. Sin inventar lo que no puede ver, y siempre con una persona que tiene la última palabra.
La conversación
La transcripción de la llamada con cada hablante identificado y el segundo en que habla, o los mensajes del chat con su hora. Teléfonos y documentos van enmascarados.
Los metadatos
Canal, dirección, duración, fecha, la tipificación registrada y los campos del ticket que elegiste mostrar en Flujos › Tickets.
El scorecard
Cada criterio con sus instrucciones para Auto QA, su modo (estándar, crítico, soft), si admite no aplica y su lista de root causes.
Tu empresa
La descripción del workspace («agencia de cobranzas que gestiona carteras de…») y los términos clave, para que entienda nombres propios y jerga.
Rating por criterio
Cumple, no cumple o, si el criterio lo permite, no aplica.
Justificación
Dos o tres frases que explican la decisión en los términos de la instrucción.
Cita
El fragmento exacto de la conversación que prueba el rating, con el hablante.
Root causes
Sólo en los no cumple y sólo de la lista del criterio.
Confianza
Interna: un crítico con confianza baja no anula la evaluación y queda marcado «Para revisar».
Un ejemplo
Así se lee una evaluación de Auto QA
Cada criterio muestra el rating, la justificación y la cita. Si el evaluador cambió algo, aparece como corrección con su feedback y la evaluación lleva el badge Revisada.
Leer una evaluación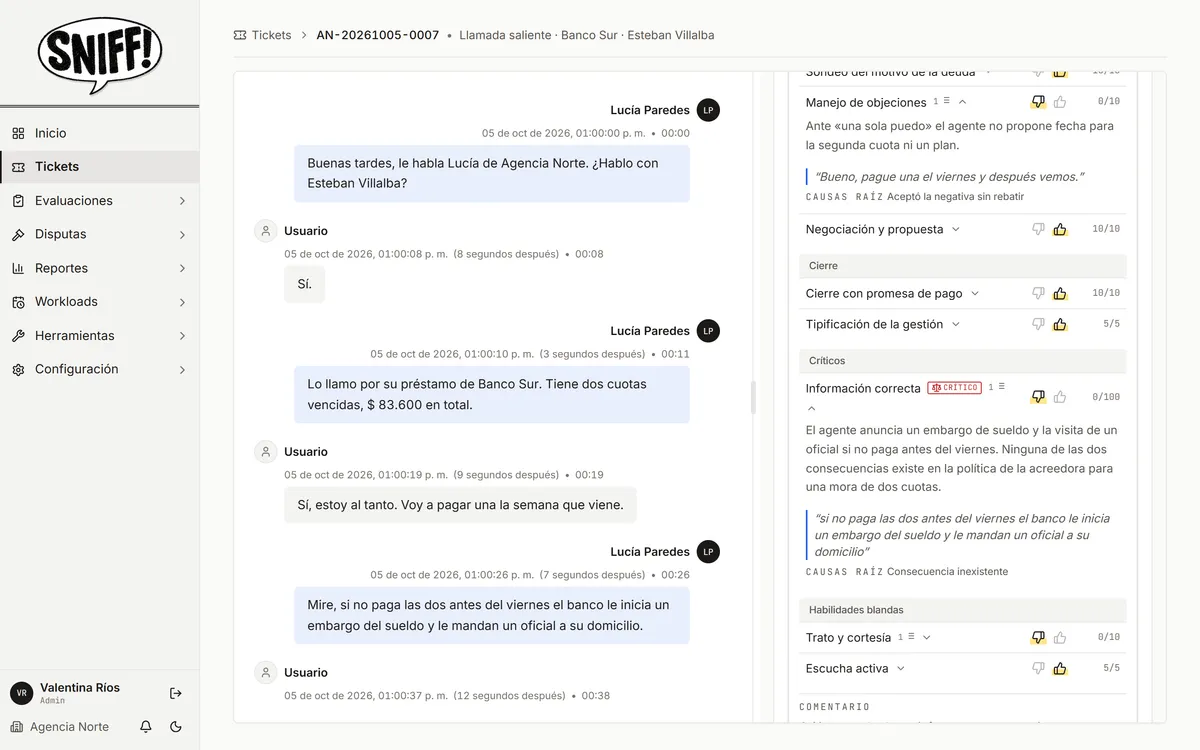
Sin humo
Lo que la IA no puede ver, lo dice
Un buen evaluador sabe cuándo no tiene datos. Auto QA también.
Datos del sistema
Si el criterio exige comparar con el saldo, la cuota o la cartera y eso no llega como campo del ticket, la IA no lo ve: lo califica como cumple salvo evidencia en contra y lo marca para revisar.
Tipificación
Sólo puede juzgarla si la tipificación registrada llega como metadato de la gestión.
Lo que pasó fuera de la conversación
Escalamientos internos, notas en otro sistema, cierres por inactividad del panel.
Audio difícil
Un solo hablante detectado, mala calidad o un contestador: la gestión queda salteada o con los hablantes marcados como dudosos, y el evaluador lo ve.
El ciclo
Evalúa, marca, aprende de la revisión, se vuelve a correr
- 01
Evalúa
El workload elige las gestiones del ciclo y Auto QA las evalúa esa noche.
- 02
Marca
Lo dudoso (críticos con confianza baja, criterios que no admiten no aplica) queda «Para revisar».
- 03
Aprende de la revisión
Cada corrección humana con su feedback queda registrada y alimenta la precisión por criterio.
- 04
Se vuelve a correr
Cuando ajustás una instrucción, «Volver a correr Auto QA» reevalúa con la nueva, sin tocar lo ya revisado o disputado.
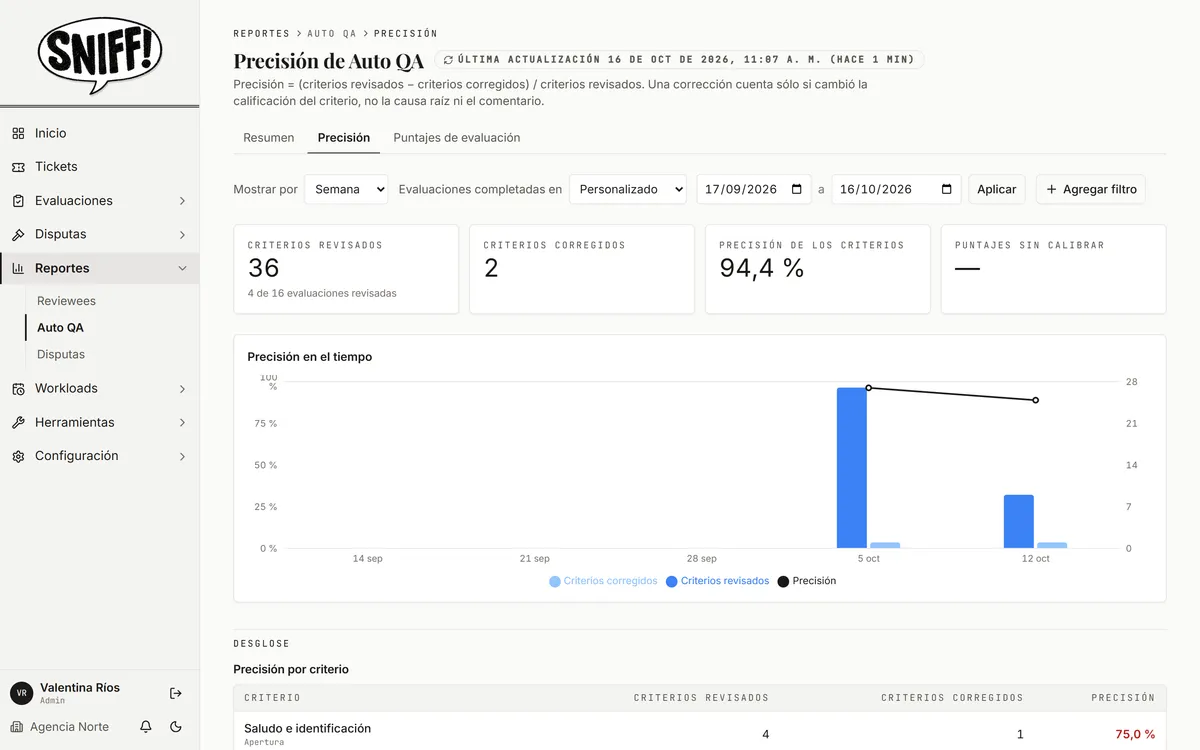
Precisión en vivo
Medida con tus propias revisiones
La precisión de Auto QA se calcula desde lo que hacen tus evaluadores: de los criterios revisados, cuántos quedaron como estaban. Por período, por criterio y por revisor, así sabés qué instrucción ajustar.
Cómo se calibra antes de salirPoné a la IA a escuchar
Y a tus evaluadores a hacer lo que sólo ellos pueden: decidir, corregir y acompañar.